
Divid: Disentangled Spatial-Temporal Modeling within LLMs for Temporally Grounded Video Understanding
Abstract
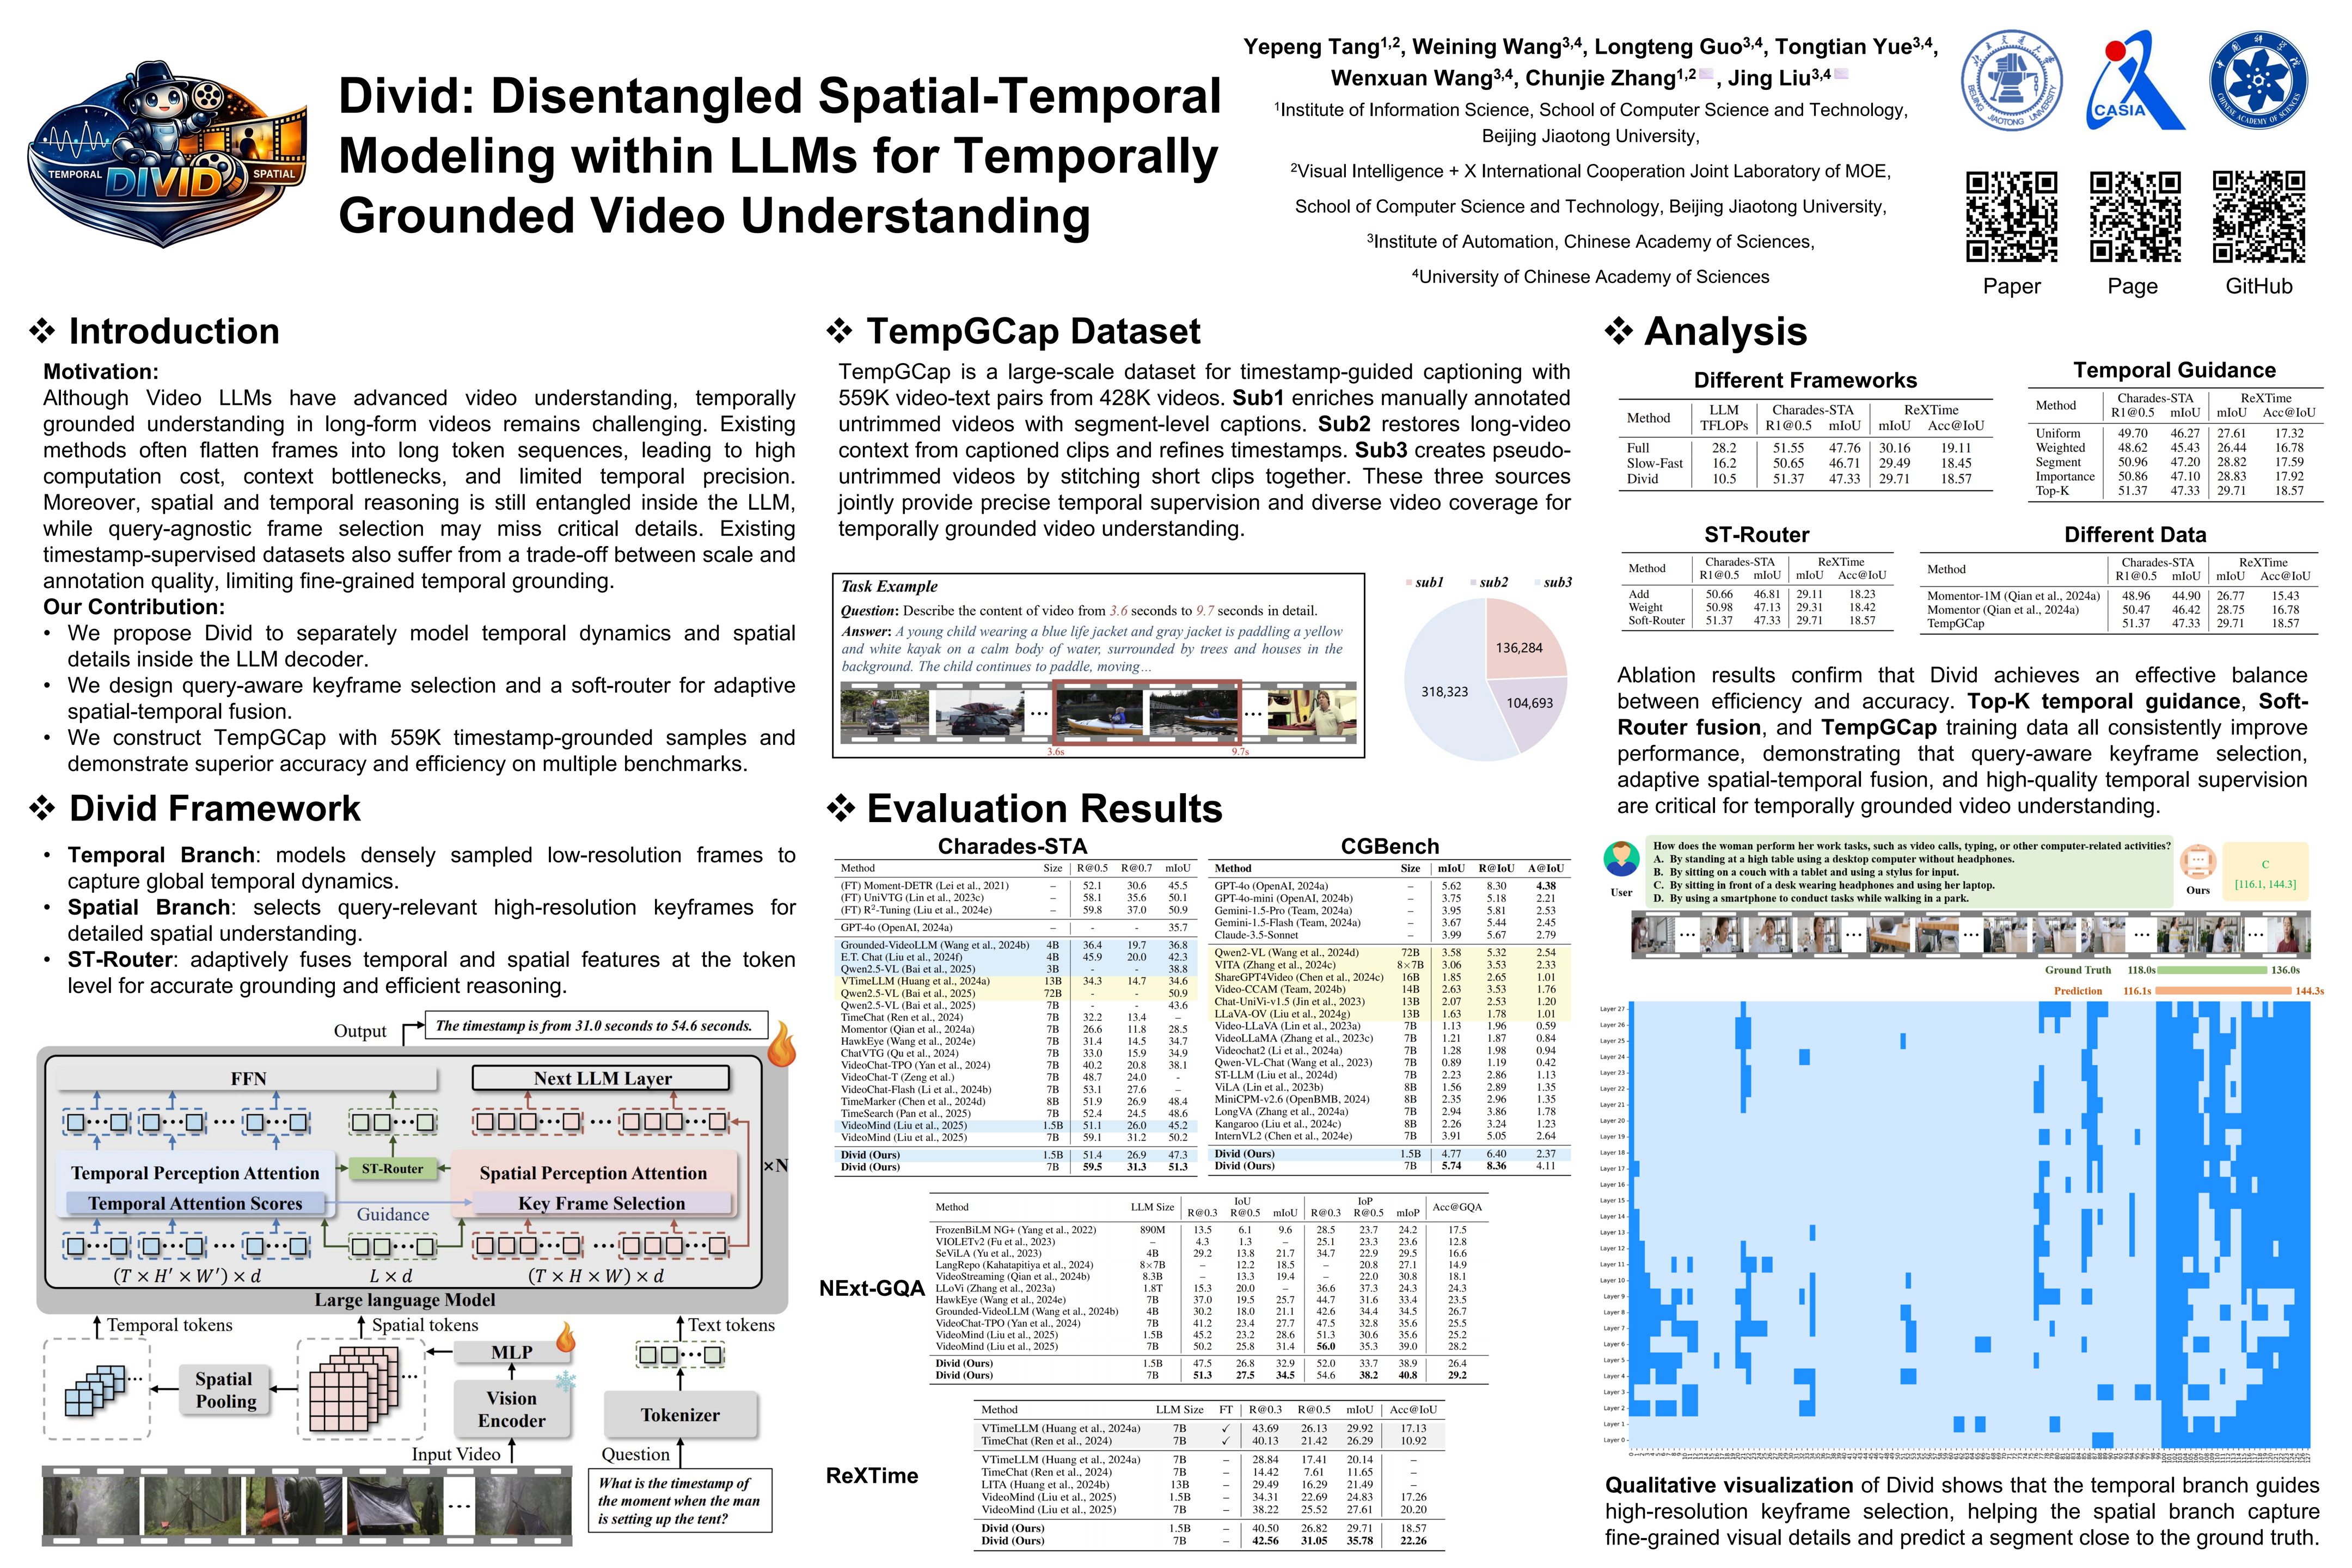
Recent advances in Video LLMs have improved video understanding performance, but temporally grounded understanding in long-form videos remains challenging. Most models encode video frames into a flat sequence of visual tokens, which are then processed together with textual input by the LLM. While effective for short videos, this approach becomes inefficient for long-form videos due to lengthy token sequences that exceed context limits and incur high computational costs. Slow-Fast architectures partially address this by separating temporal and spatial features during encoding, but these features are still processed jointly within the LLM, lacking true spatio-temporal disentanglement. Moreover, spatial features are typically sampled in a query-agnostic manner, risking the loss of task-relevant content. To address these limitations, we propose Divid, a novel dual-branch framework that explicitly disentangles spatial and temporal modeling within the LLM decoder. Specifically, the temporal branch processes densely sampled, low-resolution frames to effectively capture long-range motion dynamics, while the spatial branch selects a sparse set of high-resolution keyframes guided by temporal attention. To unify the two branches, we design a lightweight spatio-temporal soft-router that adaptively fuses temporal and spatial cues at the token level, conditioned on the input query. This disentangled architecture not only improves temporal alignment accuracy but also leads to computational savings by minimizing redundant visual processing. Furthermore, we introduce TempGCap, a large-scale dataset consisting of 559K timestamp-grounded video-text pairs, providing rich temporal supervision. Extensive experiments on temporal grounding and grounded videoQA benchmarks demonstrate the superior performance and efficiency of our proposed Divid.